Datenqualität als Voraussetzung für verlässliche KI
Die Diskussion über künstliche Intelligenz konzentriert sich häufig auf KI-Modelle und Anwendungen. Weniger Aufmerksamkeit erhält eine Voraussetzung, die entscheidet, ob ein KI-System verlässlich funktioniert: die Qualität der zugrunde liegenden Daten.
Mit dem zunehmenden Einsatz von KI wird Datenqualität zum Thema für Qualitätsmanagement, Fachbereiche und Unternehmensführung. Bei bestimmten KI-Systemen ist sie ausdrücklich Gegenstand gesetzlicher Anforderungen und damit Voraussetzung für fachlich belastbare und – wo erforderlich – regulatorisch nachweisbare KI.
Gute Einzelwerte ergeben noch keinen geeigneten Datensatz
KI-Anwendungen starten häufig mit vorhandenen Daten. Erst im Projektverlauf zeigt sich, dass Daten fehlen, unterschiedlich erhoben wurden oder nicht mehr zur aktuellen Prozessrealität passen.
Ein Beispiel: Ein Modell zur optischen Fehlererkennung wird mit historischen Prüfbildern und Gut-/Schlecht-Bewertungen trainiert. Jedes Bild kann korrekt klassifiziert sein. Der Gesamtdatensatz kann dennoch ungeeignet sein – etwa weil sich Produktvarianten, Prozesse oder Prüfkriterien verändert haben.
Das Modell lernt dann nicht die heutige Produktionsrealität, sondern die im historischen Datenbestand enthaltene Realität. Entscheidend ist daher nicht nur die Fehlerfreiheit einzelner Daten, sondern ihre Eignung und Repräsentativität für den vorgesehenen Zweck.
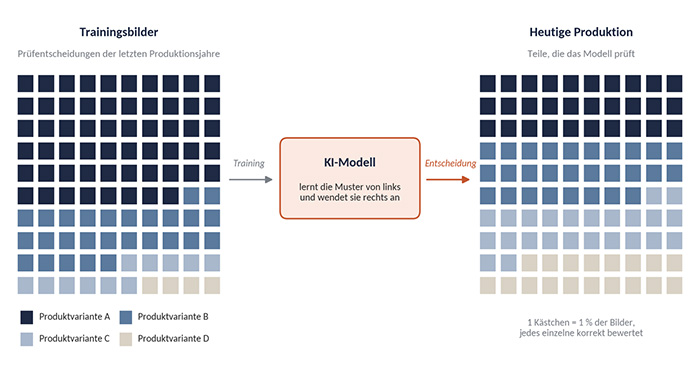
Abb. 1: Historische Daten können formal korrekt sein und dennoch die aktuelle Prozessrealität nur unzureichend repräsentieren. Ein KI-Modell übernimmt diese systematischen Verzerrungen (©Stefan Weingaertner)
Die KI-VO macht Datenqualität zum regulatorischen Thema
Artikel 10 der Verordnung (EU) 2024/1689 formuliert für bestimmte Hochrisiko-KI-Systeme konkrete Anforderungen an Trainings-, Validierungs- und Testdaten sowie an Data Governance. Dazu gehören Herkunft und Aufbereitung der Daten, mögliche Verzerrungen und Datenlücken sowie deren Relevanz und Repräsentativität.
Datenqualität ist bei diesen Systemen damit Bestandteil regulatorischer Konformität. Für KI-Anwendungen gelten dabei nicht pauschal dieselben Pflichten. Entscheidend sind die regulatorische Einordnung und die Rolle des Unternehmens.
Auch die Normung behandelt Datenqualität als Managementaufgabe
Die Normenreihe ISO/IEC 5259 behandelt Datenqualität für Analytics und Machine Learning – von Qualitätsmodellen und Messgrößen bis zu Managementprozessen und Governance.
ISO/IEC 42001:2023 ordnet den Umgang mit Daten zusätzlich in ein Managementsystem für künstliche Intelligenz ein. ISO 9001 und ISO/IEC 27001 liefern weitere Anknüpfungspunkte, etwa über faktengestützte Entscheidungen und Informationsintegrität. Integrität schützt Daten vor unzulässiger Veränderung. Ob Daten für einen KI-Anwendungsfall geeignet sind, ist damit noch nicht beantwortet.
Datenhistorie lässt sich nicht rückwirkend herstellen
Auch verschobene regulatorische Fristen ändern nichts daran: Datenhistorie und Data Lineage lassen sich später nur eingeschränkt rekonstruieren. Wer Herkunft, Aufbereitung, Qualitätsanforderungen und Modellverwendung nachvollziehbar darlegen muss, benötigt entsprechende Prozesse und Aufzeichnungen während des Datenlebenszyklus.
Datenqualität ist keine reine IT-Aufgabe
Die IT kann Datenflüsse dokumentieren, Prüfungen implementieren und Plattformen bereitstellen. Ob ein Datensatz die fachliche Realität ausreichend beschreibt, erfordert jedoch Prozess- und Domänenwissen. Deshalb braucht Datenqualität klare Verantwortlichkeiten zwischen Fachbereich, Qualitätsmanagement, Data Management, IT und KI-Verantwortlichen.
| Datenqualität für die KI-Entwicklung und als Compliance-Anforderung Datenqualität ist eine zentrale Voraussetzung für zuverlässige, sichere und regelkonforme KI-Systeme. Fehlerhafte, unvollständige oder verzerrte Daten führen zu unzuverlässigen Modellen, die schwer reproduzierbar sind und in der Praxis scheitern können. Zudem können sie zu Fehlentscheidungen, Diskriminierung und erheblichen Haftungsrisiken führen. In unseren neuen KI-Trainings zeigen wir Ihnen, warum Datenqualität der zentrale Erfolgsfaktor in der KI-Entwicklung ist. Lernen Sie im Training „Datenqualität als Compliance-Anforderung“ Methoden kennen, mit denen Organisationen diese Anforderungen wirksam, auditierbar und regelwerksübergreifend umsetzen können. Das Training „Datenqualität für die KI-Entwicklung“ kombiniert praxisnahe Python-Übungen mit moderner KI-Unterstützung durch Large Language Modellen (LLMs). Diese helfen Ihnen, Code schneller zu entwickeln, Probleme effizient zu lösen und komplexe Aufgaben in der Datenqualitätssicherung einfacher zu bewältigen. |
Vier Fragen bilden den Kern eines wirksamen Datenqualitätsmanagements
Für relevante Datensätze sollten Unternehmen mindestens vier Fragen beantworten können:
- Herkunft: Woher stammen die Daten und wie wurden sie verändert?
- Anforderungen: Was bedeutet ausreichende Datenqualität für den konkreten Zweck?
- Messung: Wie wird geprüft, ob die Anforderungen erfüllt sind?
- Abweichung: Was geschieht, wenn die Qualität nicht ausreicht?
Damit wird Datenqualität zu klassischer Qualitätsmanagementarbeit: Anforderungen festlegen, messen, Abweichungen bewerten, Maßnahmen ableiten und Wirksamkeit überprüfen.
Keine Kür, sondern Voraussetzung
Unternehmen benötigen für KI nicht einfach mehr Daten, sondern Daten, deren Eignung für den jeweiligen Anwendungsfall beurteilt werden kann. Das setzt definierte Qualitätskriterien, Verantwortlichkeiten, Messverfahren und einen geregelten Umgang mit Abweichungen voraus. Für bestimmte Hochrisiko-KI-Systeme sind solche Anforderungen Teil des regulatorischen Rahmens. ISO/IEC 5259 und ISO/IEC 42001 zeigen zugleich, dass Datenqualität zunehmend als Governance- und Managementaufgabe verstanden wird.
Datenqualität ist deshalb keine nachgelagerte Optimierungsmaßnahme. Sie ist Voraussetzung dafür, dass KI-Systeme fachlich belastbar entwickelt, kontrolliert betrieben und – soweit erforderlich – regulatorisch nachgewiesen werden können. Die zentrale Frage lautet daher nicht nur: Welches KI-Modell wollen wir verwenden? Ebenso wichtig ist: Können wir belegen, dass die Daten für diesen Zweck geeignet und verlässlich sind?
Über den Autor:
Stefan Weingaertner ist Gründer und Geschäftsführer der AltaSigma GmbH, Anbieter einer Enterprise-AI-Plattform, sowie der DATATRONiQ GmbH, einem AIoT-Lösungsanbieter für das industrielle Internet der Dinge. Er verfügt über mehr als 25 Jahre Erfahrung in Machine Learning und Künstlicher Intelligenz, insbesondere im industriellen Umfeld. Darüber hinaus ist er Hochschuldozent, Fachautor und Herausgeber der Springer-Vieweg-Buchreihe „Information Networking“. Bei der DGQ ist er als Trainer für KI- und datenbezogene Themen tätig.
Verordnung (EU) 2024/1689 des Europäischen Parlaments und des Rates vom 13. Juni 2024 zur Festlegung harmonisierter Vorschriften für künstliche Intelligenz (KI-Verordnung), insbesondere Art. 10 „Daten und Daten-Governance“, ABl. L, 2024/1689, 12.7.2024. Verordnung (EU) 2026/1744 des Europäischen Parlaments und des Rates vom 8. Juli 2026 zur Änderung der Verordnungen (EU) 2024/1689, (EU) 2018/1139 und (EU) 2023/1230 im Hinblick auf die Vereinfachung der Umsetzung harmonisierter Vorschriften für künstliche Intelligenz (Digital-Omnibus-Verordnung zur KI), ABl. L, 2026/1744, 24.7.2026. ISO/IEC 42001:2023: Artificial Intelligence Management System. ISO/IEC 5259-1:2024: Artificial Intelligence – Data quality for analytics and machine learning (ML) – Part 1: Overview, terminology, and examples.
Literaturverzeichnis
ISO/IEC 5259-2:2024: Artificial Intelligence – Data quality for analytics and machine learning (ML) – Part 2: Data quality measures.
ISO/IEC 5259-3:2024: Artificial Intelligence – Data quality for analytics and machine learning (ML) – Part 3: Data quality management requirements and guidelines.
ISO/IEC 5259-5:2025: Artificial Intelligence – Data quality for analytics and machine learning (ML) – Part 5: Data quality governance framework.